Autor: magoolation

  • Capacitação Microsoft AI — Aula 2: LLMs e engenharia de prompts

    Segundo artigo da série que acompanha as aulas da Capacitação Microsoft AI 2026. Na aula 1 chegamos ao modelo com a montagem mínima; nesta aula a montagem é exatamente a mesma — o que muda é o que colocamos no contexto.

    O que a aula cobriu

    Como um modelo grande de linguagem funciona por dentro — tokens, probabilidade, janela de contexto — e o que isso significa para quem escreve o prompt. Depois, três técnicas na prática, todas sobre os mesmos três chamados de suporte, para que a comparação seja honesta: chat com histórico no cliente, few-shot e saída estruturada.

    Três ideias para levar

    1. Quem guarda o histórico: o serviço ou o cliente?

    Na aula 1 o programa guardava só um ConversationId e o serviço lembrava a conversa. Aqui fazemos o oposto: uma List<ChatMessage> que cresce a cada turno e é enviada inteira. Mesmo IChatClient, mesmo endpoint, mesma identidade. A escolha não é de tecnologia, é de arquitetura: histórico no cliente dá controle total sobre o que entra no contexto (e sobre o custo em tokens); histórico no serviço simplifica o código e facilita retomar conversas.

    2. Few-shot não é um recurso da API, é uma conversa fictícia

    Em vez de descrever o formato de resposta que você quer, você mostra: monta uma conversa em que o assistente “já respondeu” daquele jeito e entrega como se tivesse acontecido. O modelo continua o padrão. Na demo, zero-shot devolve markdown livre; few-shot devolve Acesso | Alta | ... em uma linha.

    List<ChatMessage> exemplos =
    [
        new(ChatRole.System, "Você classifica chamados de suporte. Responda SEMPRE em uma única linha, no formato: Categoria | Urgência | Resumo."),
        new(ChatRole.User, "O sistema fechou sozinho quando cliquei em salvar."),
        new(ChatRole.Assistant, "Erro | Alta | Aplicação encerra ao salvar."),
        // ... mais dois pares
    ];
    
    List<ChatMessage> mensagens = [.. exemplos, new ChatMessage(ChatRole.User, chamado)];
    var resposta = await chatClient.GetResponseAsync(mensagens);

    3. Saída estruturada: um record em vez de texto solto

    Quando a resposta vai alimentar código — e não uma pessoa — pedir “com jeitinho” não basta. GetResponseAsync<T>() gera um JSON Schema a partir do seu record, envia junto com o prompt e desserializa a resposta. O modelo fica obrigado pelo serviço a produzir JSON válido naquele formato.

    record TriagemChamado(string Categoria, string Urgencia, string Resumo, bool RequerAtencaoImediata);
    
    var resposta = await chatClient.GetResponseAsync<TriagemChamado>(mensagens);
    TriagemChamado triagem = resposta.Result;

    Antes de rodar

    • Tudo o que valia na aula 1: .NET 10, Azure CLI com az login, papel Foundry User, FOUNDRY_ENDPOINT (do projeto) e FOUNDRY_MODEL (nome do deployment).
    • Os pacotes são os mesmos e nas mesmas versões. Microsoft.Extensions.AI e Microsoft.Extensions.AI.OpenAI ficam em 10.4.1 — é a única versão compatível com o OpenAI 2.9.1 que os pacotes Azure exigem. Subir sem --version compila e quebra em runtime.
    • O <NoWarn>OPENAI001</NoWarn> no .csproj não é opcional: AsIChatClient() ainda é experimental e o SDK promove o aviso a erro.

    Se você está na trilha Python

    As três demos existem em Python: histórico numa lista de mensagens, few-shot do mesmo jeito, e saída estruturada com Pydantic no lugar do record. Mesmo AIProjectClient e mesmo endpoint da aula 1.

    Próximo passo

    Rode a demo 2 duas vezes com o mesmo chamado — uma zero-shot, outra few-shot — e compare as respostas. Depois troque um dos exemplos do few-shot e veja como o modelo segue o novo padrão. Na aula 3 entramos no Microsoft Foundry de verdade: recurso, projeto, deploy de modelos e o SDK com resposta em streaming.

    Dúvidas ou algo que não funcionou? Deixe nos comentários ou abra uma issue no repositório.
  • Capacitação Microsoft AI — Aula 1: Fundamentos de IA e o ecossistema Microsoft

    Este é o primeiro de oito artigos que acompanham as aulas da Capacitação Microsoft AI 2026, que Otávio Lourenço da Silva e eu ministramos ao vivo entre agosto e setembro. As gravações continuam no ar; os artigos existem para quem prefere ler, revisar ou copiar o código com calma.

    O que a aula cobriu

    A primeira aula constrói a base que todas as outras usam: o que é IA generativa e onde ela se encaixa no ecossistema Microsoft (Copilot, Microsoft Foundry, Azure), e o caminho mínimo — e correto — entre uma aplicação e um modelo hospedado no Foundry. Saímos da aula com um chat de console funcionando, e com três decisões de arquitetura que se repetem em todo o curso.

    Três ideias para levar

    1. Autenticação sem segredo

    Não existe chave de API no código. O Foundry SDK autentica sempre por Entra ID: DefaultAzureCredential descobre quem você é a partir do ambiente (az login na sua máquina, identidade gerenciada em produção) e o mesmo código roda nos dois lugares sem alteração. Não há segredo para vazar em log, repositório ou print de tela.

    O tropeço clássico vem logo depois: ser Owner da subscription não basta. O Azure separa permissões de gerenciamento (criar e apagar recursos) de permissões de dados (conversar com o modelo). Owner tem as primeiras e nenhuma das segundas — você autentica com sucesso e recebe 403 Forbidden. O papel que resolve é o Foundry User, atribuído no recurso Foundry.

    2. Uma abstração entre você e o fornecedor

    Entramos pelo AIProjectClient (o Foundry SDK), pegamos um cliente de Responses para o deployment do modelo e o convertemos em um IChatClient de Microsoft.Extensions.AI. Daí para cima, o código não menciona mais nem Azure nem OpenAI. Trocar o modelo por um Ollama local é mexer nestas três linhas — e em nada mais.

    AIProjectClient projectClient = new(
    endpoint: new Uri(endpoint),
    tokenProvider: new DefaultAzureCredential());
    ProjectResponsesClient responseClient = projectClient.ProjectOpenAIClient
    .GetProjectResponsesClientForModel(model);
    IChatClient chatClient = responseClient.AsIChatClient(model);

    3. Contexto mantido pelo serviço

    O chat lembra o que foi dito antes, mas o programa não guarda histórico nenhum: ele guarda apenas um ChatOptions.ConversationId e o serviço cuida do resto. Na aula 2 fazemos o oposto — o histórico numa lista que cresce no cliente — com o mesmo IChatClient, justamente para comparar as duas estratégias.

    Antes de rodar

    • .NET SDK 10 e Azure CLI instalados, com az login feito no tenant certo.
    • Um recurso Foundry com um modelo implantado e o papel Foundry User atribuído à sua conta.
    • As variáveis FOUNDRY_ENDPOINT (endpoint do projeto) e FOUNDRY_MODEL (nome do deployment, não o nome comercial do modelo) no seu launchSettings.json.
    • Não altere as versões dos pacotes. O projeto converge para um pivô único (OpenAI 2.9.1); subir qualquer pacote compila e quebra em tempo de execução. O README da aula explica a matriz de versões.

    Se você está na trilha Python

    A mesma aula existe em Python 3.12+: AIProjectClient, cliente OpenAI e contexto no serviço via previous_response_id. Em Python não existe o problema do pivô de versões do .NET, e um único endpoint do projeto serve todas as aulas — mas a regra de fixar versões no requirements.txt continua valendo.

    Próximo passo

    Rode o chat, faça duas perguntas encadeadas e confirme que o modelo lembra a primeira. Depois abra o Program.cs e leia os comentários — eles foram escritos para serem lidos, não só para explicar o código. Na aula 2 entramos em LLMs e engenharia de prompts: contexto no cliente, few-shot e saída estruturada.

    Dúvidas ou algo que não funcionou? Deixe nos comentários ou abra uma issue no repositório.

  • try.dot.net: Um ambiente .NET a um clique de distancia

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Depois de muito tempo tento voltar aqui. Em breve publico mais novidades sobre minha trajetória profissional mas hoje venho com algo que me surpreendeu positivamente. As vezes precisamos fazer algumas provas de conceito, provar que algo funciona de determinada forma dentro da linguagem, experimentar alguma nova feature do compilador mas nÃo temos nem tempo, e as vezes nem abiente para fazer estes testes. O correto agora é dizer que não tinhamos. A algum tempo temos o site https://try.dot.net onde podemos escrever e testar nossos códigios em um ambiente totalmente online. A impressão que me passa é que este site é praticamente o editor C# do Visual Studio Code embarcado em um site, e o resultado é realmente muito rápido. Espero que ajudem nos estudos de C#! Até a próxima!
  • Vou palestrar no Xamarin Dev Summit 2019

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! O título parece familiar mas não estou falando do Xamarin Summit Brasil, o maior evento de Xamarin da América Latina, o qual em breve trarei novidades. Estou falando do Xamarin Developers Summit organizado pelo Dan Siegel e que acontecerá dias 11 e 12 de julho no Texas, USA. Na útima sexta-feira recebi a confirmaçao e irei apresentar pela primeira vez uma palestra totalmente no idioma da rainha e de quebra falar sobre acessibilidade. Estou muito feliz com mais este reconhecimento e espero de verdade que eu possa compartilhar uma mensagem de que acessibilidad é sim algo fundamental em nossos aplicativos e que em Xamarin.Forms é muito fácil de se implementar. Até a próxima!
  • NVDA Driver para Selenium

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Sabe aquelas coisas que você pensa: “como nunca pensaram nisto antes?”. A genialidade do meu amigo e também MVP @kastwey realmente me deixou muito empolgado. Trata-se de um driver para Seleium que permite usar o NVDA (leitor de telas open source) para realização de testes automatizados com base na acessibilidade. Como assim? Ao invés de realizar as ações no navegador vocêconsegue aferir se o que o leitor de telas leu é o comportamento esperado. Com isto podemos fazer uma automação muito mais precisa e os testes de acessibilidade com base em uma navegação “real” do usuário e não a verificação de atributos do HTML. O código pode ser encontrado em https://github.com/kastwey/nvda-testing-driver e você também pode instalar o pacote nuget. Neste fim de semana devo por as mãos nesta obra de arte e provavelmente colocar um vídeo aqui dos resultados. Até a próxima!
  • Windows 10, WSL, docker e máquinas virtuais

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Tivemos no grupo do WhatsApp da lista de cegos programadores uma discussão bem interessante sobre o uso do WSL (Windows Subsystem for Linux), docker e máquinas virtuais. É sábido de muitas pessoas com deficiencia visual que necessitam utilizar virtualização que nem sempre o desempenho dos leitores de tela nas máquinas emuladas é satisfatório, principalmente quando temos o Windows como sistema hospedeiro. Outro grande problema é a forma como nos comunicamos com softwares que rodam nestas máquinas, tais como servidores, infraestrutura e etc. Apesar de passar boa parte do meu dia utilizando Parallels e Windows 10 dentro de um OSX, meu mundo dos sonhos seria ter uma máquina Windows full time, utilizando todo poder de fogo mas mesmo assim podendo desenvolver e depurar aplicativos iOS. O serne da questão é que quando utilizamos docker reduzimos praticamente a zero a necessidade de ambientes Linux para quem está acostumado a ambiente Windows. Desde que se saiba o que que se está fazendo podemos empacotar e utilizar diversos aplicações Linux dentro de containers de forma totalmente transparente. Dando um exemplo, tenho o pandoc, um convertedor universal de formatos de textos, gerador de PDF, ePub e outros, rodando no docker sem a necessidade de investir um minuto em infraestrutura para ter um ambiente rodando. Logicamente o WSL nos trouxe outras possibilidades como o desenvolvimento inclusive de aplicações C++ totalmente em uma máquina Windows mas com target em distribuições Linux. Para projetos iniciados em ambiente Linux, com diversos scripts shell a migração também se torna transparente. Mas como eu disse, cada variável a mais que adicionamos em nossa infra, mais um ponto de atenção adicionamos a nossa lista de verificações quando estamos fazendo um troubleshooting. De forma bem reduzida diria que um ambiente saudável hoje tem Windows 10, docker e no máximo WSL. Qualquer ingrediente am ais é arriscado para a sua receita dar certo. O que você tem usado? Até a próxima!
  • Quais as atribuições de um desenvolvedor em 2019?

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Recentemente palestrei sobre empregabilidade de pessoas com deficiencia, mas um dos tópicos que comentei me remeteu a algo muito interessante que vem acontecendo com nosso mercado de trabalho. Logicamente que existem os processos de recrutamento sem noção e que pedem um profissional impossível de se encontrar ao preço que eles querem bancar, mas na verdade quais são as atribuições, justas, de um desenvolvedor nos nossos dias? A muito tempo deixamos de ser apenas os atendedores de pedidos. Não apenas recebemos uma demanda e a codificamos da melhor forma com a melhor qualidade, mas também automatizamos testes, enviamos os códigs para um ou mais ambientes, os quais muitas vezes os momntamos também de forma automatizada e logicamente nos empenhamos em sermos os mais ágeis possível na solução dos problemas que infelizmente só foram detectados em produção. Ou seja estamos em todo o ciclo do desenvolvimento participando desde as reuniões de definições técnicas do início do projeto até a monitoração da nossa entrega em produção. Em empresas maiores você acaba dividindo estas atribuições com outros papéis, arquitetos, profissionais de infra, etc. mas em empresas menores e principalmente nas Startups ter esta dedicação é mais que desejável, é o que acaba tornando a operação via’vel nos primeiros dias sem clientes. E o que podemos fazer para ir além? Venho estudado muito sobre métricas, tanto do ponto de vista de analisar como minha solução está performando tecnocamente, quanto o quanto ela está atingindo os clientes. Tenho brincando com o ‘dados analíticos de nossos usuários e verificando de forma mais objetivas porque determinada funcionalidade é mais ou menos utilizada, ou quais conjuntos de chamadas a API trazem menor tempo de resposta, ou quais dados nm são tão utilizados assim. Isto tem me trazido insights bem interessantes de possível próximos passos e como otimizar o tempo do time naquilo que realmente traz valor. Acredito que cada vez mais isto será papel do time como um todo, em que muito tempo não teremos mais “donos” de atividades, e precisaremos cada vez mais de times com atitude. E você? O que tem feito de diferente e que virou sua atribuição? Até a próxima!
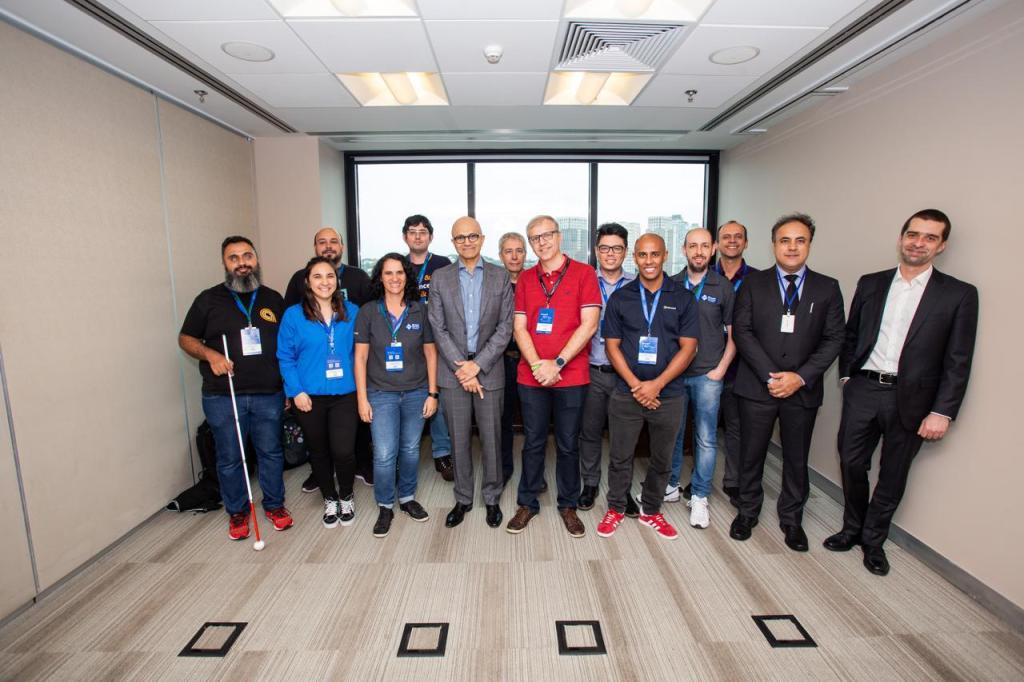
  • O dia em que conheci Satya Nadella

    O dia em que conheci Satya Nadella

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Foi uma semana muito intensa com viagens, palestra e uma foto que marca um momento tão importante para minha vida pessoal e profissional. Na última terça-feira dia 12 ocorreu em São Paulo o evento Microsoft AI+ Tour que teve como keynote o CEO Satya Nadella que trouxe em seu discurso muita inspiração e insights sobre as oportunidades que se abrem quando se une vontade e tecnologia. Ele reforçou muito um conceito o qual ele aplica diariamente na Microsoft a Tech Intensity, ou seja, não basta termos a tecnologia a disposição, temos de ter intensidade em aplicaça-la. Mas o dia só estava começando eu nem imaginava o quanto ele poderia melhorar. Participei deste evento pois tive a honra de ser convidado, juntamente com mais nove MVPs, a partificar de uma foto com o Satya. Seria algo muito rápido, afinal a agenda de um CEO é realmente controlada minuto a minuto. Na hora de nos posicionarmos para recebe-lo fui colocado estratégicamente como primeiro da fila, e ao ouvir que ele havia entrado na sala só tive uma reação a de extender minha mão para cumprimentá-lo e ao perceber que ele estava próximo dizer “Thank you for changing my life!” (Obrigado por mudar minha vida). Após cumprimentar todos na sala, e nos posicionarmos como haviamos ensaiado duas vezes, afinal o tempo era nosso inimigo, foram tiradas algumas fotos e logo após ele novamente se direcionou a mim perguntando quais tecnologias eu trabalhava. Falei que usava o Visual Studio, Visual Studio Code e Azure e ele me perguntou sobre a acessibilidade. Relatei que els haviam melhorado muito nos últimos anos, que me sentia satisfeito e que eles estavam no caminho certo. Logicamente que o pouco tempo que eu teria não iria chorar as pitangas do portal do Azure. Ele disse que sabe o quão importante é ter ferramentas acessíveis e que o desafio dlees atualmente é manter a consistencia, ou seja, o que estiver bom continuar bom e introduzir novas melhorias. Ele me cumprimentou novamente e aos demais participantes apenas perguntou quais as tecnologias. Coisas que gostaria de ressaltar: é impressonante a simplicidade e simpatia do Satya. Ele estava a todo momento sorrindo, e posteriormente ouvindo como como foi a passagem dele no Brasil só aumentou minha adimiração pelo mesmo. A energia naquela sala realmente mudou desde a hora que ele entrou, e meu dia foi baseado na ansiedade de receber aquela foto e poder postar. A segunda coisa é o quanto ele onhece o seu público, seja ele em qual seja o ambiente. Ele deu uma visão muito boa de negócios para a Inteligencia Artificial, foco claro do evento, mas conseguiu flar de tecnologia com os MVPs perguntando das das ferramentas que usavamos e fazendo comentários rápidos sobre as mesmas. Depois da foto ele ainda teve uma reunião com todos os funcionários da Microsoft Brasil, falou com alunos de escola pública, deu uma palestra para participantes de uma ONG e a noite ainda viajaria para Colombia. E mesmo assim, em todos os momentos ele estava sempre sorrindo, sempre cumprimentando a todos e mesmo assim ele conseguiu nos atender, e dedicar 1/5 do tempo que ele tinha conosco falando comigo. Sem sombra de duvidas é um dos dias mais importantes da minha vida e me mostra que não importa quantos degrais subamos, quando olharmos ao redor temos de ver a todos com o mesmo tamanho pois subir não quer dizer ser melhor. Áté a próxima!
  • O que aprendi nos últimos 18 meses com Code Review

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Já durante o processo para entrar para ArcTouch já tive meu primeiro contato com a cultura de Code Review e esta é uma prática muito importante de nosso processo. Nenhum código deveria ser integrado sem antes passar por pelo menos um outro desenvolvedor, e em tarefas de desenho ou atualização de User Interfaces de um designer (com anexos dos screenshots). Em um primeiro momento achei isto um pouco invasivo, e de certa forma, até um pouco preocupante já que alguém estaria criticando diretamente o meu trabalho, o código que fiz. Mas o efeito é totalmente o contrário. Quando comecei a eceber os primeiro feedback sobre meu código percebi algumas lacunas na forma de pensar para resovler um problema. Muitas vezes estamos tão preocupados em primeiro entregar a solução, que não nos atentamos prática de refatorar o nosso código para que ele seja de melhor qualidade. Percebi também que eu tinha gaps de testes, que existem áreas que eu preciso melhorar meu feramental, ou seja estou crescendo muito como profissional com as dicas que vim recebendo no caminho. E isto é uma rua de mão dupla. Toda vez que vejo um código penso em como consigo tornar o trabalho dos meus pares ainda melhor,dando uma dica do que sei, indicando um problema que não havia sido percebido. O github torna este processo muito agradável. E tenho aprendido cada vez mais a fazer melhores reviews. Inclusive se quiserem fazer qualquer tipo de comentários lá nos meus repositórios, por avor fiquem a vontate. Até amanhã!
  • A revolução dos dados

    Este artigo foi publicado em 2019. Ferramentas e versões citadas podem ter mudado desde então; a reflexão permanece.

    Fala galera! Como citei no artigo sobre DDD comecei a programar em Clipper no inicio dos anos 90. Lá eu guardava os dados dos meus sistemas em tabelas dBase, um arquivo por tabela, e seus respectivos índices, um arquivo por índice. Havia uma quantidade mínima de tipo de dados, e principalmente uma limitação no tamanho dos discos. Existia uma forma peculiar de relacionamento, que auxiliava apenas nas buscas de dados relacionados por um índice, mas nada de integridade referencial. E cometiamos um erro, que muitos sistemas cometem até hoje, de destuir a informação anterior em detrimento de mante-la atualizada. O que quero dizer com isto? No meu sistema de vendas o produto de código A00931 foi cadastrado inicialmente com a descrição de Pão de Forma sem casca. A tabela de vendas tinha apenas uma referencia a partir do código, o valor unitário, a quantidade. Um belo dia o produto deixava de ser vendido, e para reaproveitar o código ele era substituído por Suco de maracujá. O que acontecia se eu pedisse um relatório de vendas? Pareceria que eu havia vendido inúmeros sucos, sendo que o produto acabou de chegar. Muitossistemas fazem iso até hoje. Colocam que em segurança dos dados por guardar um log de auditoria com a data e hora do que foi alterado. Mas como eu consulto a informação dentro da linha do tempo? Como ei qual o produto mais vendido, independnete das atualizações que este cadastro sofreu? Justifiquei meu erro da época pela tecnologia e limite limitações da época, aliadas a minha pouca experiencia. Mas o que nos faz continuar errando até hoje? As pessoas não aprenderam nem a importancia dos dados, e levam as formas normais ao extremo. Bancos de dados ‘relacionais muito úteis, e que terão uma longa vida pela frente, é usado como um paradigma mais seguro. Mas como sempre não existe bala de prata. Quando comecie a ver bancos de dados NoSQL em um primeiro momento todas as preocupações e questionamentos me vieram a cabeça. Mas como? Mas e a chave estrangeira? Mas e a consistencia? Fui estudando cada vez mais e me apaixonando pelo que cada tipo de banco de dados faz de melhor, e como o ermo pesistencia poliglota faz sentido e que quem não entendeu isto ainda esta fadado a não só tr um produto de menor qualidade, mas de estar desperdiçando dados importantes para o negócio do seu cliente. E a persistencia poliglota eu extendo não só ao fato de usar diferentes tecnologias d bancos. Cada vez mais precisamos que nossos micro servi;ços, eles aqui novamente, tenham independencia, seus próprios dados, e mecanismos robustos de sincronização, mas com total entendimento e tolerancia a ocasionais inconsistencia. O resultado? Um mar de dados para ser navegado pelos analistas e cientistas, um emaranhado de bits e bytes que ‘Machine Learning transformam em decisões conscientes e negócios sendo mais acertivos e reduzino drasticamente seus custos. Se isto não é uma revolução, preciso de mais dados para descobrir oque é! Até amanhã!